电装 DENSO 自动驾驶大模型算法实习生
本文迁移自 知识星球原文,保留原始发布日期;作者统一署名 determine。
入职前学习准备与安排
适用对象:determine 岗位:自动驾驶大模型算法实习生(研发方向) 准备目标:入职后 1 周内跑通环境和项目,2 周内能够独立完成一个小模块,1 个月内做出可量化的优化结果。
重要原则:不再继续堆砌概念,而是围绕岗位实际任务准备——日报 Agent、RAG、专利/技术资料整理、自动驾驶数据处理、模型评测与工程落地。
一、先明确这个岗位到底做什么
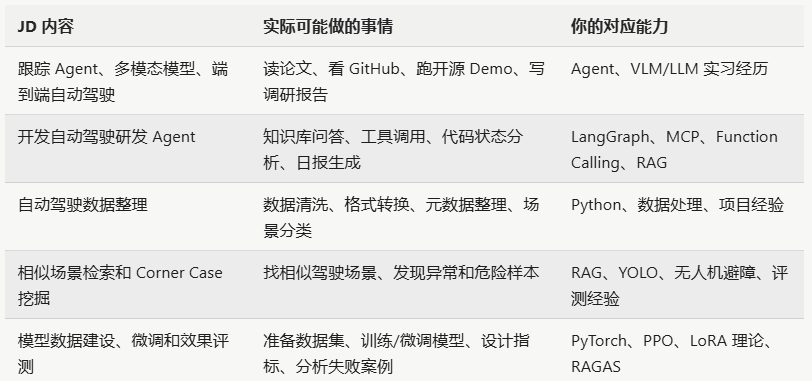
1. 从 JD 看岗位职责
岗位职责可以翻译成五类工作:
2. 面试官透露的实际工作
根据一面内容,团队目前主要是前端研发和技术探索,不是量产开发。可能涉及:
- 日报 Agent:收集 AI、自动驾驶新闻,以及团队代码开发状态,自动生成日报;
- 专利和知识产权整理:分析公司内部专利,生成报告,构建专利-技术-产品矩阵;
- 数据整理:处理不同来源、不同格式的研发数据;
- 前沿技术跟踪:关注大模型、Agent、世界模型、VOM 等方向,并与国内前沿 startup 对接;
- 研发辅助工具:使用大模型、RAG、工具调用和工作流提升团队效率。
因此,入职前最重要的不是把自己包装成“自动驾驶全栈专家”,而是证明:
我能够快速理解业务数据,搭建一个可用的 Agent/RAG 原型,并用指标和案例持续优化。
二、入职前必须修正的几个问题
1. 不要再把“熟悉 LoRA/QLoRA”说成“做过微调”
一面已经暴露出:你的简历写了熟悉 LoRA,但实际没有独立完成大模型微调。入职后如果继续模糊表达,容易造成预期落差。
建议统一口径:
“我目前对 LoRA/QLoRA 的原理、训练流程和参数配置有理论了解,在 Step-RL 项目中接触过 Qwen3-8B 和 LoRA 相关方案,但还没有独立完成一个完整的大模型微调项目。入职前我会补做一个小规模的 SFT/LoRA 实验,熟悉数据格式、训练、验证和推理部署流程。”
入职前至少完成一个小实验:
2. 修正 PPO 和 SAC 的表述
你在一面中把 PPO 说成“短期奖励”、SAC 说成“长期奖励”,这个说法不准确。二者都可以处理长期序列决策,根本区别不是短期和长期。
正确口径:
- PPO:on-policy,使用当前策略采样数据,通过 clipped objective 限制策略更新幅度,训练相对稳定;
- SAC:off-policy,使用 replay buffer,并加入最大熵目标,鼓励探索,样本利用率更高;
- PPO 与 SAC 都会估计 value/Q value,区别在于策略更新方式、数据利用方式和熵正则机制;
- SAC 在动态障碍场景成功率更高,应该基于实验结果解释为探索能力和样本利用率可能更适合该场景,不能简单说成“它是长期奖励”。
3. 不要混淆 ROS 和仿真建模工具
一面中你提到 ROS 可以搭建无人机模型,面试官进行了纠正。以后要明确:
- ROS/ROS2:机器人操作系统,更准确地说是通信中间件和工具生态,用于节点通信、消息传输、传感器和控制模块连接;
- Gazebo、Isaac Sim、PyBullet:仿真环境或物理仿真平台,用于搭建机器人、场景和动力学模型;
- Gymnasium:强化学习环境接口;
- Gym-PyBullet-Drones:基于 PyBullet 的无人机强化学习仿真环境。
正确回答:
“我最初考虑过 ROS 和更完整的仿真系统,但由于复试和毕业设计时间紧,最终使用 Gym-PyBullet-Drones 完成了无人机三维仿真和强化学习训练。ROS 更偏通信和机器人系统集成,PyBullet 则承担了当前项目中的物理仿真功能。”
4. 搞清楚自己的 Self-RAG 到底做了什么
一面面试官追问 Self-RAG 时,你一时没有定位到简历中的具体实现。入职前必须把代码重新打开,确认:
- Self-Critique 是什么节点;
- 输入是什么;
- 输出是什么;
- 依据哪些规则判断回答是否需要修正;
- 修正最多循环几次;
- 是否真正使用了检索证据;
- 有没有评测前后效果。
如果实际只是“生成后让 LLM 再评价一次”,不要夸大成完整论文意义上的 Self-RAG。可以诚实说:
“我的实现更接近基于 LLM Critique 的轻量级自我检查机制,而不是完整复现论文中的训练式 Self-RAG。它的流程是生成答案后检查引用是否支持结论,若证据不足则重新检索、修正或拒答。”
三、入职前学习优先级
P0:必须掌握,直接对应实际工作
1. RAG 全链路
必须能完整讲清楚:
重点掌握:
- PDF、Markdown、网页、代码文件的解析差异;
- Chunk Size、Overlap、按标题切分、按语义切分;
- Embedding 和 Rerank 的区别;
- 向量检索、BM25、混合检索;
- RRF 融合原理;
- 查询改写、HyDE 的适用场景;
- Self-Critique、Self-RAG 和普通二次审查的区别;
- Recall@K、Precision@K、MRR、NDCG;
- Faithfulness、Answer Relevancy;
- 如何定位 RAG 效果差的具体环节。
2. 日报 Agent 方案
准备一个可以在 3-5 分钟内讲清楚的设计:
要能解释四个问题:
- 如何接入数据:新闻、代码提交、CI 结果、测试报告、内部文档分别采用什么方式接入;
- 如何生成报告:使用固定模板,而不是让模型自由发挥;
- 如何逼近历史报告:抽取历史报告的结构、标题、表达风格,用 few-shot 或模板约束;
- 如何保证可靠性:每个结论关联来源,关键数字校验,低置信度内容标记,人工审核后回流。
3. Agent 工作流和工具调用
重点掌握:
- Function Calling 的完整流程;
- 工具名称、描述、参数 Schema 如何设计;
- LangGraph 的 State、Node、Edge、Conditional Edge;
- ReAct 和 Plan-and-Execute;
- Supervisor、Handoff、并行执行;
- 超时、重试、降级、最大步数;
- 工具返回格式统一;
- 并发任务如何管理;
- MCP 的 Host-Client-Server 架构;
- Tools、Resources、Prompts 三类原语。
你需要能画出:
4. Python 数据处理
入职后很可能接触大量数据整理,而不只是调用 LLM。复习:
- pathlib、os、json、re、csv;
- pandas 数据清洗、合并、去重、缺失值处理;
- NumPy 基础;
- JSON、JSONL、CSV、Parquet;
- Pydantic 数据校验;
- 日志记录和异常处理;
- 多进程/多线程基础;
- API 请求、分页、限流和重试;
- Git diff、commit log 等代码状态信息提取。
建议做一个小练习:
读取一批模拟新闻 JSON、Git 提交记录和测试报告,统一转换为标准事件格式,去重后存入 JSONL,再生成一份 Markdown 日报。
P1:一周内补齐,直接对应 JD
1. 自动驾驶基础链路
至少理解:
- 目标检测、跟踪、分割、深度估计;
- BEV 表示;
- 多传感器融合;
- 轨迹预测;
- 运动规划与控制;
- 端到端自动驾驶;
- Corner Case;
- 数据闭环和仿真评测。
2. 端到端、VLM、VLA、世界模型
端到端 vs 模块化
模块化方案把感知、预测、规划、控制拆开,结构清晰、便于定位问题,但模块之间可能存在信息损失,误差也可能逐级传递。端到端方案可以直接从多模态输入预测轨迹或动作,能够整体优化,但数据需求大、解释和验证更困难。实际工程中更可能采用带安全约束、监控和降级机制的融合方案,而不是简单二选一。
VLM vs VLA
- VLM:视觉-语言模型,重点是理解图像/视频并输出文字或语义结果;
- VLA:视觉-语言-动作模型,进一步输出机器人或车辆可执行的动作;
- 自动驾驶中,VLM 可以用于场景理解、数据标注、问答和风险解释;VLA 更接近决策和控制,但对安全、实时性和验证要求更高。
世界模型
世界模型是学习环境状态变化规律的模型。给定当前场景和动作,它尝试预测未来场景。自动驾驶中可能用于长尾场景生成、仿真训练、规划评测和数据增强。
结合本次面试要注意:
面试官说世界模型和 VOM 是团队需要跟踪、但当前没有重点投入人力的方向。因此入职交流中应理解其技术价值,但不要误说成团队当前核心项目。
3. Corner Case 挖掘
Corner Case 可以理解为:
低频但容易导致系统失败或风险升高的特殊场景。
例如:
- 夜间强反光;
- 雨雪雾天气;
- 遮挡严重;
- 异形车辆;
- 行人突然横穿;
- 施工区域;
- 传感器异常;
- 罕见道路结构;
- 预测和规划冲突。
基本挖掘流程:
P2:入职后逐步深入
- Qwen、DeepSeek、InternLM 基础使用;
- Qwen-VL、InternVL 的图像输入和推理格式;
- 视觉数据、视频数据基本处理;
- OpenCV、PIL、ffmpeg;
- 点云基本概念和 Open3D 入门;
- Elasticsearch 基础;
- CUDA 和 GPU 显存基础;
- C++ 基础和推理部署;
- ONNX、TensorRT、量化;
- ISO 26262、功能安全概念;
- ROS2 和机器人系统通信。
四、14 天入职前学习计划
如果距离入职不足 14 天,按照 P0 → P1 → P2 顺序压缩。每天有效学习 3-4 小时即可,不建议熬夜堆时长。
Day 1:复盘与环境整理
- 重新阅读岗位 JD;
- 阅读自己的 Agent 和 RAG 代码;
- 把简历上每个数字标注“测试方法”;
- 把“做过、参与过、了解过”分清;
- 建立一个入职前 Git 仓库或本地学习目录;
- 确认正式入职日期、地点、设备要求。
当天产出:
Day 2:RAG 文档处理
学习:
- PDF/TXT/Markdown 加载;
- 清洗、切分、元数据;
- Chunk Size 和 Overlap;
- 代码文档和普通文本的差异。
实践:
- 准备 10-20 份公开技术文档;
- 分别使用 256、512、1024 长度切分;
- 记录检索结果差异。
当天产出:RAG 离线入库脚本 + 参数对比表。
Day 3:混合检索与 Rerank
学习:
- Embedding;
- BM25;
- 向量检索;
- RRF;
- Cross-Encoder Rerank;
- Recall@K、Precision@K、MRR。
实践:
- 设计 20-30 个测试问题;
- 对比纯向量、纯关键词和混合检索;
- 统计 top-k 命中率。
当天产出:检索方案对比报告。
Day 4:查询改写、HyDE 和引用校验
学习:
- 查询改写适用场景;
- 指代消解;
- 多问题拆分;
- HyDE 的优点和额外 LLM 成本;
- 引用回溯;
- 证据不足时拒答。
实践:
- 为 10 个口语化问题设计改写模板;
- 记录改写前后召回差异;
- 为回答增加文档来源和页码。
当天产出:查询改写模块 + 引用输出样例。
Day 5:Agent 工具调用
学习:
- Function Calling JSON Schema;
- 工具参数校验;
- 工具错误处理;
- ReAct;
- 最大步数和超时。
实践:
- 实现 3 个工具:新闻搜索、代码状态查询、日报保存;
- 统一工具返回格式;
- 注入工具超时和错误,测试重试逻辑。
当天产出:可运行的最小 Agent。
Day 6:LangGraph 工作流
学习:
- State;
- Node;
- Edge;
- Conditional Edge;
- 并行节点;
- Checkpoint;
- 中断和恢复。
实践:
当天产出:日报 Agent V0.1 流程图和 Demo。
Day 7:日报 Agent V0.1
完成一个最小闭环:
不要追求复杂,重点是:数据能进来、报告能生成、来源能追溯。
当天产出:一份可展示的 Markdown 日报和 README。
Day 8:专利/技术资料矩阵
学习:
- 长文本摘要;
- 技术领域分类;
- 关键词和实体抽取;
- 专利相似度;
- 去重;
- 专利-技术-产品矩阵。
实践:
- 使用公开专利或技术文章;
- 抽取标题、申请人、技术主题、关键词、应用产品;
- 输出 CSV 或 Markdown 矩阵。
当天产出:技术资料结构化表格和矩阵示例。
Day 9:模型微调基础
学习并完成一个小实验:
- SFT 数据格式;
- LoRA A/B 低秩矩阵;
- learning rate、batch size、epoch;
- train/eval 划分;
- loss 曲线;
- adapter 保存和加载;
- 微调前后对比。
当天产出:LoRA 微调实验记录,不需要追求大模型或高指标。
Day 10:自动驾驶基础
学习:
- 感知、预测、规划、控制;
- 目标检测和跟踪;
- BEV;
- 端到端;
- 场景数据;
- Corner Case。
实践:
- 画一张自动驾驶系统链路图;
- 为你的 YOLOv8 车辆检测项目补充“它位于感知模块”的解释;
- 为无人机安全投影层补充“与自动驾驶安全约束的关系”。
当天产出:自动驾驶基础一页纸。
Day 11:相似场景检索和 Corner Case
设计一个简单流程:
重点理解:
- 仅靠向量相似度不一定能找到危险样本;
- 需要组合模型置信度、规则、轨迹异常和人工标记;
- 召回候选后还需要人工复核。
当天产出:Corner Case 挖掘方案图。
Day 12:评测体系
整理三类评测:
RAG 评测
- Recall@K;
- Precision@K;
- MRR/NDCG;
- Faithfulness;
- Answer Relevancy。
Agent 评测
- 任务完成率;
- 工具调用成功率;
- 平均步骤数;
- 平均延迟;
- 重试率;
- 人工干预率。
自动驾驶数据/模型评测
- 场景覆盖率;
- 低置信度样本召回率;
- Corner Case 发现率;
- 误报率;
- 漏报率;
- 失败案例分布。
当天产出:评测指标表和 20 条测试样例。
Day 13:工程化和部署
复习:
- Dockerfile;
- requirements.txt/pyproject;
- FastAPI;
- 日志;
- 配置文件和环境变量;
- API Key 管理;
- GPU/CPU 设备切换;
- Git 分支、commit 和 PR。
检查你的项目:
- 新电脑能否一键安装?
- 没有 API Key 时是否有明确报错?
- 模型调用失败是否会重试?
- 文档路径是否写死?
- 日志中是否打印了敏感信息?
当天产出:项目 README 和部署检查表。
Day 14:完整模拟与总结
模拟回答以下问题:
- 请介绍你的 Agent 项目;
- 日报 Agent 怎么设计;
- RAG 检索效果不好怎么办;
- 多 Agent 如何并行;
- 工具调用失败怎么办;
- 你如何处理自动驾驶数据;
- Corner Case 怎么挖掘;
- LoRA 微调是否真正做过;
- PPO 和 SAC 的区别;
- 你的项目数字怎么测出来的。
当天产出:
五、如果距离入职只有 3 天
第一天:修正基础概念
重点复习:
- RAG 全流程;
- 向量检索/BM25/Rerank;
- Function Calling;
- LangGraph;
- PPO/SAC 正确区别;
- ROS 与仿真平台的区别。
第二天:准备岗位任务
重点完成:
- 日报 Agent 架构图;
- 专利矩阵示例;
- 数据清洗流程;
- Corner Case 挖掘流程;
- 评测指标表。
第三天:工程准备和入职确认
- 检查 Python、Git、Docker、Linux 环境;
- 准备个人电脑;
- 准备项目 README;
- 确认正式入职时间、地点、联系人;
- 休息,不再大量学习新概念。
六、入职第一周工作安排
第一天:先跑通,再提建议
需要确认:
- 项目目标;
- 数据来源;
- 代码仓库;
- 模型和 API;
- GPU/云端权限;
- 评测指标;
- 交付时间;
- 代码提交规范;
- 哪些数据可以带出,哪些不能。
建议表达:
“我先把现有流程完整跑通,画出数据流和模块关系,再针对一个最明确的指标做小范围优化。”
第 2-3 天:画图和记录
输出:
- 当前系统流程图;
- 数据字段说明;
- RAG 入库和检索流程;
- Agent 工具清单;
- 已知问题清单;
- 运行环境说明。
第 4-5 天:找一个小切口
优先选择容易量化的任务:
- 增加一个数据解析器;
- 修复 PDF/Markdown 解析问题;
- 增加一个检索过滤条件;
- 加入报告引用;
- 降低重复新闻;
- 增加工具失败重试;
- 增加一个评测脚本。
不要第一周就提出“重写整个系统”。最重要的是先交付一个可验证的小结果。
七、第一个月的目标
第 1 周:跑通和理解
目标:能够独立启动项目,知道每个模块做什么。
第 2 周:建立 Baseline
目标:整理数据集和测试问题,记录优化前指标。
例如:
第 3 周:完成一次优化
选择一个方向:
- 混合检索;
- Rerank;
- 文档切分;
- 查询改写;
- 报告模板;
- 数据去重;
- 工具调用异常处理。
第 4 周:形成技术总结
总结格式:
这份总结既是工作成果,也可以成为后续争取留用的重要材料。
八、入职时建议主动确认的问题
业务问题
- 日报 Agent 当前最希望先解决哪个问题?
- 目前已有历史日报和固定模板吗?
- 哪些信息源是最重要的?
- 报告最终由谁审核?
- MVP 预计什么时候交付?
技术问题
- 目前使用自部署模型还是云端 API?
- 使用哪些开源模型?Qwen、DeepSeek、InternVL 是否已经接入?
- 当前向量数据库和关键词检索方案是什么?
- 有没有现成评测集?
- GPU 和云端资源如何申请?
- 代码和数据的权限边界是什么?
管理问题
- 任务通过什么方式分配?
- 每周是否有固定同步?
- 代码如何 review?
- 实习生的交付标准是什么?
- 遇到问题时优先找哪位同事沟通?
九、入职后的沟通原则
1. 不懂时不要装懂
正确表达:
“这个方向我目前只了解基本原理,还没有实际做过。我先确认一下现有代码和数据格式,今天给出一个最小验证方案。”
2. 不要只报告“我做完了”
应该汇报:
“我完成了 X,使用 Y 数据进行测试,指标从 A 变成 B,主要改善来自 C,目前还有 D 类失败案例。”
3. 先确认需求再写代码
至少确认:
- 输入是什么;
- 输出是什么;
- 谁来使用;
- 什么时候交付;
- 如何验收;
- 哪些内容必须准确;
- 哪些内容可以由人工确认。
4. 保护公司数据
- 不把公司代码上传个人 GitHub;
- 不把内部专利、报告、数据发到公开模型;
- 不在个人电脑长期保存敏感数据;
- 不截图传播内部系统;
- API Key 使用环境变量管理;
- 公开写作时只使用脱敏或虚构数据。
十、最终准备优先级
必须完成
- 能脱稿讲清 RAG 全链路;
- 能画日报 Agent 架构图;
- 能解释向量检索、BM25、RRF、Rerank;
- 能说明 PPO 和 SAC 的正确区别;
- 能区分 ROS、PyBullet、Gymnasium;
- 能诚实说明 LoRA 实际经验边界;
- 能完成一个小型 LoRA 微调实验;
- 能完成一个新闻+Git 状态日报 Demo;
- 能说清 Corner Case 挖掘基本流程。
有时间再做
- Qwen-VL/InternVL 图像推理;
- OpenCV 视频抽帧;
- Elasticsearch 入门;
- Open3D 点云入门;
- ONNX/TensorRT 部署;
- ROS2 通信基础;
- 世界模型和 VOM 论文跟踪。
最终目标
入职前不需要把所有技术都学完。真正的目标是做到:
面对一个真实任务,能够先拆需求,再设计数据流和 Agent 工作流,快速跑出 Baseline,建立评测指标,找到失败案例,并通过一次小范围实验证明自己的优化有效。
这正是这个岗位最需要的能力,也是你从“做过 Agent 项目”成长为“能够参与企业研发 Agent 落地”的关键一步。
评论与交流
评论管理 ↗