电装(DENSO)自动驾驶大模型算法实习生 —— 面试速查手册
本文迁移自 知识星球原文,保留原始发布日期;作者统一署名 determine。
面试时间:8月17日 A场 10:00-10:30 / B场 14:00-14:30(线上面试) 地点:上海闵行区元电路35号 电装中国上海技术中心(免费班车) 定位:Agent工程落地(RAG/工具调用)+ 多模态/VLM认知(端到端自动驾驶)+ 项目深挖(数据/模型/落地)+ 英语能力 本手册由 14 份准备文件合并,定制版内容(自我介绍/项目/HR)已按你的真实简历写好。
目录
- 0 面试信息与优先级 · 1 自我介绍(定制) · 2 项目讲述(定制) · 3 技术考点速查
- 4 算法手撕(完整代码) · 5 HR行为面试(定制) · 6 英语面试 · 7 电装研究 · 8 反问与当天清单 · 9 简历问题提醒
0. 面试信息与优先级
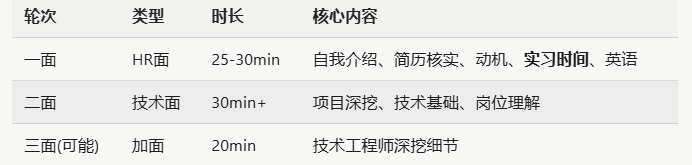
复习优先级:①定制自我介绍+项目(12/13内容)→ ②技术考点(Transformer/RAG/Agent/VLM/微调)→ ③定制HR面+公司研究 → ④手撕+反问+清单
一句话:电装面试 = Agent工程基础(RAG/工具调用)+ 多模态/VLM认知(端到端自动驾驶)+ 项目深挖(数据/模型/落地)+ 英语能力
1. 自我介绍(定制版·直接背)
1.1 中文 2 分钟版
面试官您好,我叫determine,成都理工大学人工智能专业应届本科毕业生,今年 9 月将进入上海交通大学机械专业攻读硕士,学习研究方向是智能机器人系统、大语言模型智能体和强化学习决策优化。
过去两年我主要做了两类工作。第一类是 Agent 与大模型应用:我独立开发了基于 ReAct 和 LangGraph 的多工具智能 Agent 系统,完整实现了 Function Calling 工具调用、双层记忆、RAG 知识增强和 Docker 部署;还开发了带自我反思机制的 RAG 智能问答系统,在清华四川能源互联网研究院实习时参与了 VLM 与多智能体方向的研究。第二类是强化学习与具身决策:基于 gym-pybullet-drones 做了无人机动态避障算法对比研究,独立设计安全投影层,训练初期碰撞率降低 80%,相关工作代码全部开源。
技术栈方面,我熟练掌握 Python、PyTorch 和 Linux,熟悉 LangGraph、MCP、ChromaDB、FastAPI、Docker 这套 Agent 工程链路;了解 LoRA/QLoRA 微调,做过模型压缩与端侧部署——把 110M 的模型蒸馏到 18M 后在 Jetson 上用 TensorRT 部署,也把 YOLOv8n 压到 6.2MB 在 CPU 上实时车辆检测。
我了解到电装这个岗位主要做三件事:用大模型 Agent 辅助自动驾驶研发、构建场景数据的智能检索与 Corner Case 挖掘、探索 VLM 与自动驾驶算法的结合。这三点和我的背景高度契合——我已经把 Agent 和 RAG 完整落地过,也做过车辆检测这类感知任务和安全约束的决策算法,非常希望把这些经验用到自动驾驶这个真实场景里,同时补齐端到端和 VLM 的认知。电装是丰田集团旗下的全球头部汽车零部件供应商,在 ADAS 和生成式 AI 研发上投入很大,我很期待在这里向资深工程师学习。谢谢!
1.2 30 秒精简版
面试官您好,我叫determine,成都理工大学人工智能本科毕业,今年 9 月进入上海交通大学读机械硕士,方向是智能机器人与大模型智能体。我独立开发过基于 LangGraph 的多工具 Agent 系统和带反思机制的 RAG 问答系统,也做过无人机强化学习避障(安全投影层降低 80% 碰撞率)和 YOLOv8 车辆检测轻量化部署。我认为"大模型+自动驾驶"这个方向非常好,而且电装这个岗位做研发 Agent 和场景数据智能检索,和我的经历很匹配,所以来面试。谢谢!
1.3 英文 2 分钟版
Good morning, distinguished interviewer. My name is determine. I'm a recent graduate from Chengdu University of Technology with a bachelor's degree in Artificial Intelligence, and I will start my master's degree in Mechanical Engineering at Shanghai Jiao Tong University this September, focusing on intelligent robotic systems, large language model agents, and reinforcement learning.
In the past two years, I have mainly worked on two tracks. The first is LLM agents and applications: I independently built a multi-tool agent system based on ReAct and LangGraph, covering function calling, dual-layer memory, RAG knowledge enhancement, and Docker deployment. I also developed a RAG question-answering system with a self-reflection mechanism, and I interned at the Tsinghua Sichuan Energy Internet Research Institute, where I worked on multimodal and multi-agent research. The second track is reinforcement learning for embodied decision-making: I built a UAV obstacle-avoidance benchmark on gym-pybullet-drones and designed a safe projection layer that reduced the early-training collision rate by 80%.
My tech stack includes Python, PyTorch, and Linux, plus the agent engineering chain of LangGraph, MCP, ChromaDB, FastAPI, and Docker. I also have model optimization experience: I distilled a model from 110M to 18M parameters and deployed it on Jetson with TensorRT, and I compressed YOLOv8n to 6.2MB for real-time vehicle detection on CPU.
I learned that this position focuses on three things: building R&D agents for autonomous driving, intelligent retrieval and corner-case mining over driving data, and exploring how VLM can benefit perception and planning. This aligns well with my experience in agent engineering, data pipelines, and safe decision-making. DENSO is a global top-tier automotive supplier with strong investment in ADAS and generative AI, and I would love to grow here. Thank you.
1.4 学历衔接话术(JD要求硕士在读,必被问)
我今年 9 月正式入学上海交通大学(C9),目前处于本科毕业到硕士入学的衔接期,可以立刻到岗全职实习。入学后我也和学校确认过,硕士课程可以安排在晚上和周末集中修读,白天可以保证每周 4-5 天实习,能稳定实习 3 个月以上。我理解岗位希望实习生长周期投入,这一点我可以承诺。 (若学校实际不能保证 → 如实说"开学后具体排课还在确认,我可以先全职到开学,再和导师协商")
2. 项目讲述稿(定制版)
讲述顺序:①Agent系统(3min) → ②RAG系统(2min) → ③Step-RL(2min) → ④无人机(2min) → ⑤YOLOv8(1min) 每个项目结尾用"电装连接话术"把话题带回岗位。所有数字都要能说清"怎么测出来的"。
2.1 项目① ReAct+LangGraph 多工具智能 Agent(主推)
讲述稿:
这个项目是我在清华四川能源互联网研究院实习期间及之后独立开发的,目标是把一个"能调工具、有记忆、能检索知识"的通用 Agent 完整落地,从需求分析做到 Docker 部署。架构四层: 工具层:基于 Function Calling 定义统一工具接口 schema,集成搜索/计算/天气/网页抓取等 10+ 工具,支持热插拔;分层路由——简单查询走关键词规则直达工具不经过 LLM,延迟从 2s 降到毫秒级;复杂查询才交 LLM 语义决策。 记忆层:短期 deque 滑动窗口管理会话上下文;长期 JSON 持久化用户画像与历史,形成"写入—存储—检索—加载"闭环,保障 20 轮以上对话连贯。 工作流层:LangGraph 把"任务理解→规划→工具调用→反馈"建模成节点化状态图,条件路由、异常回退、最大步数限制、错误重试;系统鲁棒性提升 40%,冒烟测试通过率 14/15。 知识层:完整 RAG 链路(解析→递归切分→ChromaDB→检索增强生成),支持 PDF/Markdown 问答,调 chunk size 和 top-k 后幻觉率降约 20%。 最后 FastAPI 封装 6 个 REST 端点、Gradio WebUI、Docker 一键部署,RAGAS 四维指标搭评估体系。 最大挑战:Agent 长任务易卡死/跑偏 → 工程兜底(最大步数+超时+重试+路由降级)。核心收获:Agent 可靠性主要靠流程工程,不是模型本身。
电装连接:换成电装场景 = 知识库换成技术文档/标注规范、工具换成"场景检索/仿真调用/报告生成",就是岗位要做的"自动驾驶研发 Agent"雏形。
追问应对:
- 工具路由?→ 关键词规则表命中,否则 LLM 语义分类,两级兜底
- 鲁棒性+40%怎么测?→ 故障注入(超时/异常/JSON解析失败)前后冒烟测试对比
- 幻觉-20%怎么测?→ 100题人工抽检 + RAGAS faithfulness
- 为什么 ChromaDB?→ 千级 chunk 够用、轻量带持久化;规模上来换 Milvus/ES
- MCP 做什么?→ 工具服务层按 MCP 风格组织,动态注册/发现
- 工具失败怎么办?→ schema 校验 + 重试 + 错误信息回传 LLM 换策略
2.2 项目② RAG 增强型智能问答系统(主推)
讲述稿:
偏检索链路深度优化。文档加载/切分/向量化/查询改写/重排全部解耦成可插拔模块,44 项 pytest 单测全覆盖。 检索侧四个优化:混合检索(语义向量+BM25 并行召回融合,解决型号/变量名精确词漏召回);Rerank(召回 20 条→重排取 top-5);查询改写(口语化→规范);HyDE(LLM 生成假设答案→用其向量检索)。 生成侧 Self-RAG 式反思:生成后自动批判检查,支撑不足就修正或拒答,降低"流畅但错误"。 评估用 RAGAS 四维指标(faithfulness/relevancy/precision/recall)。收获:RAG 项目 70% 功夫在数据和检索,模型是最后一步。
电装连接:把检索对象从文本换成多模态场景特征(VLM 抽特征向量入库),就是"相似场景检索 + Corner Case 挖掘"的雏形——这是我到岗后最想做的方向。
追问应对:
- 混合检索怎么融合?→ RRF 或加权和合并排序
- HyDE 流程?→ LLM 生成假设答案→embed→查库→真实文档作答
- 为什么 Rerank?→ 向量是双塔近似,交叉编码器精算相关度,提升最明显
- 44 项单测测什么?→ 切分边界/查询改写/检索top-k/prompt组装/schema校验/引用回溯
- 3 种 embedding 切换?→ 统一接口+工厂模式(ONNX/OpenAI/Sentence-Transformers)
2.3 项目③ Step-RL(RL×LLM Agent 长链路决策)
讲述稿:
解决 Agent 长任务奖励稀疏问题(任务 25 步才成功,中间无反馈,PPO 难学)。 核心一 Progress Estimator:Qwen3-8B + 轻量 MLP 给每步打"进度贡献分",把终局延迟奖励拆成稠密中间反馈。核心二 Grounding Signal:实时校验按钮可点击性/元素存在性/页面加载状态,过滤无效动作并入奖励惩罚,动作锚定准确率 96.2%。 PPO + "进度贡献分+动作有效性分"加权奖励:电商任务完成率 85%→90%,时长缩短 28%(25s→18s),用户干预率→8%。 意义:RL 处理长链路稀疏奖励的方法用在大模型 Agent 上,与"LLM 辅助驾驶规划决策"是同一类问题(多步决策、稀疏反馈、安全约束)。
追问应对:
- Progress Estimator 怎么训?→ Qwen3-8B+MLP 回归,label 来自轨迹后验进度标注,LoRA 微调底座
- 奖励组合?→ w₁×进度分 + w₂×动作有效性分,做过权重消融
- 为什么 PPO?→ Agent 决策需稳定 on-policy 更新
- 96.2% 怎么测?→ 人工标注无效动作 vs 模型判定一致率
- 会被"刷分"吗?→ Grounding Signal 校验动作真实有效,防假动作骗奖励
2.4 项目④ 无人机 DRL 动态避障(第一作者毕设)
讲述稿:
针对领域三大痛点(对比失范/安全缺失/代码不公开),用 gym-pybullet-drones 搭统一仿真环境,集成 PPO/SAC,4 组对照、12 次独立训练。 核心贡献规则化安全投影层:a_safe = Proj(a_raw) ∈ C = {a | g(a) ≤ 0},从机制上避免训练初期碰撞,碰撞率降低 80%。 结果:SAC 密集动态障碍下成功率比 PPO 高 8%,PPO 收敛更平稳;代码全部开源。
电装连接:无人机与自动驾驶都是动态障碍下安全决策;安全投影层思路 = 自动驾驶 safety filter / 安全冗余设计;仿真对照实验方法(统一环境+多随机种子+多维指标)可直接用于端到端算法评测。
追问应对:
- 投影层数学形式?→ 到约束集 C 的最近点映射
- 80% 怎么统计?→ 训练初期固定 episode 碰撞次数,加层前后对比
- 为什么 SAC 好?→ 熵正则+off-policy 数据利用率高;代价收敛波动大
- 12 次怎么组织?→ 4 组对照 × 3 种子
- 能直接用于自动驾驶?→ 方法论可迁移,真实车辆动力学/交通规则需重新建模
2.5 项目⑤ YOLOv8 车辆检测与端侧部署(60秒)
YOLOv8n 基线 6.2MB,F1 曲线选置信度阈值 0.259;ONNX 导出 + INT8 量化,纯 CPU 25ms/帧实时;模型预热机制,端到端响应 3.8s→2.4s;Django 全栈,3 用户并发,mAP@50 0.639。理解了检测"训练→阈值→量化→部署"全链路与精度/速度平衡。 追问:为什么 YOLOv8n(小/够用/生态好);0.259 怎么选(F1-confidence 曲线最优点);25ms 什么设备(桌面 CPU)。
2.6 备选弹药(一句话版)
- 光伏预测(IEEE CISAT 2025 EI 第二作者):KNN 降尺度+随机森林,RMSE-18.7%、R²=0.92 → 数据处理/特征工程能力(对应 JD"数据整理清洗结构化")
- BERT 110M→18M 蒸馏 + Jetson TensorRT:延迟-95.6%、显存-75%、精度损失~1.8% → 模型工程(对应 JD"模型建设/微调")
- 循迹避障小车(实训满分):STC32/PCB/C语言 → 硬件系统工程素养(日企加分)
- 脉冲星计时噪声(数维杯国际二等奖):傅里叶回归拟合 97%+ → 科研复现能力
2.7 讲项目铁律
- 每个数字能说清"怎么测出来的";2. 每个选型有"对比过什么";3. 主动讲失败/坑;4. 不会的诚实说+给推测;5. 每讲完一个项目用一句电装连接话术收尾。
3. 技术考点速查
3.1 Transformer 与深度学习
Self-Attention:Attention(Q,K,V) = softmax(QKᵀ/√d_k)·V
- Q=查询(想找什么)、K=键(能回答什么)、V=值(实际内容);用 Q 匹配所有 K 得权重,加权求和 V
- 为什么除以 √d_k:点积随维度增大方差变大→softmax 饱和区→梯度消失;除以 √d_k 拉回方差 1
- 多头:拆 h 个头在不同子空间并行学不同关系,拼接后线性投影
- 位置编码:注意力置换不变→需注入位置;sin/cos、可学习、RoPE(LLaMA/Qwen,旋进 Q/K)
- Decoder-only:causal mask 只看过去,自回归生成;是主流(预训练/生成目标统一)
- 复杂度 O(N²d);KV Cache 缓存历史 K/V 只算新 token;Flash Attention 分块避免 N×N 中间矩阵(显存 O(N))
训练:
- BF16 vs FP16:BF16 指数位同 FP32,动态范围大更稳,大模型标配;FP16 需 loss scaling
- 梯度累积:显存不够时累 N 步更新一次,等效大 batch
- ZeRO(DeepSpeed):Stage1/2/3 分片优化器状态/梯度/参数
- AdamW + warmup + 余弦退火
3.2 Agent 与 RAG(岗位核心)
RAG 流程:文档加载→切分(语义边界+10-15%重叠)→Embedding→向量库→Query(改写/HyDE)→检索(混合+重排)→拼Prompt→生成(带引用)→评测
- 切分最影响效果;embedding 中文用 bge-m3/bge-large-zh
- 向量库选型:FAISS=库/单机原型;Chroma=轻量易用;Milvus=分布式生产级;Pinecone=SaaS;ES=全文强可混合
- 混合检索:向量+BM25(精确词)→ Rerank(cross-encoder 精排 top-5)提升最明显
- HyDE:LLM 生成假设答案→用其向量检索
- 幻觉控制:检索质量+prompt 约束(只依据检索内容,找不到说不知道)+引用可追溯+评测监控
- RAG vs 微调 vs 长上下文:RAG=私有/实时知识更新(换库秒级);微调=风格/能力塑造;长上下文=单文档超长但贵、lost-in-the-middle
Agent:
- ReAct:Thought→Action→Observation 循环,灵活可纠偏、可解释;缺点 token 多、可能死循环(设最大轮数);适合未知探索
- Plan-and-Execute:先全量计划再执行;稳定省 token;适合流程明确任务(报告生成)
- 面试答法:动态规划 vs 静态规划的取舍;实际常"粗粒度计划+子任务内 ReAct"
- Function Calling:tools 数组(name/description/parameters JSON Schema)→ 模型返回 tool_calls → 程序执行 → tool 结果回传 → 继续生成。description 写好选对工具率才高
- MCP(Anthropic 2024.11):统一工具接入协议("工具界 USB-C");Host-Client-Server;三个原语 Tools/Resources/Prompts;传输 stdio/SSE/Streamable HTTP
- LangGraph:状态机图(节点=LLM/工具,边=条件路由),支持循环/子图/人工介入;vs LangChain 线性链
- 多 Agent:Supervisor(主分任务给专家)、Handoff(移交)、辩论/评审;坑=死锁/重复劳动→明确职责+限轮数
评测:检索 Recall@k/MRR/NDCG;生成 faithfulness/relevancy;Agent 任务成功率/轮数/工具调用准确率
3.3 LLM/VLM 与自动驾驶
端到端 vs 模块化:模块化=感知→预测→规划独立,可解释可调试,但信息瓶颈(目标框丢细节)+误差累积;端到端=传感器→轨迹可微联合优化,信息无损,但难解释/难调试/数据需求大。行业现状:模块化为主+端到端增量演进。 UniAD(2023 CVPR 最佳论文):query-based 统一 Track/Map/Motion/Occ/Plan,规划目标反推感知任务;后续 SparseDrive 去 BEV 更快。
VLM 通用范式:Vision Encoder(ViT) → Projector → LLM
- Projector:把视觉特征映射到文本嵌入空间(线性/MLP=LLaVA;Q-Former=BLIP-2)
- LLaVA:两阶段——①冻结视觉编码器+LLM 只训 Projector(特征对齐)②指令微调
- Qwen-VL/Qwen2-VL:原生多模态,图片/多图/视频、高分辨率分块
- InternVL:上海AI实验室,对标 GPT-4V
- 为什么自动驾驶用 VLM:开放世界语义(互联网预训练)、可解释(输出推理链)、自然语言交互、零样本长尾
VLM vs VLA:VLM 输出文本(理解);VLA 输出动作(决策执行);RT-2 把动作离散化成文本 token 用 next-token 训练。
World Model:学状态转移(当前帧+动作→未来帧);GAIA-1(Wayve)/UniSim;用途=仿真数据生成(低成本长尾)、策略训练环境。
开源模型速记:Qwen(中文+工具调用首选)、DeepSeek(推理/代码)、InternLM/InternVL(多模态中文)、LLaVA(结构简单讲原理)、Llama(英文生态)
3.4 微调 / 评测 / 数据处理
LoRA:冻结原权重只训低秩矩阵 h = Wx + BAx(r=8~64,可训练参数<1%);为什么有效:权重更新呈低秩性(intrinsic dimension 小);省显存:不存原权重梯度,推理可合并回 W。QLoRA=4-bit 量化(NF4)+LoRA。
- vs 全参:LoRA 省显存/多任务切换便宜/接近全参效果;全参数据足算力够时上限高
- 防遗忘:混通用数据、小 lr、LoRA 本身缓解
推理优化:量化(GPTQ/AWQ/GGUF,INT8/INT4)、Flash Attention、KV Cache+PagedAttention(vLLM)、投机解码、蒸馏
评测指标:
- LLM:Perplexity/MMLU/GSM8K/HumanEval/C-Eval
- RAG:Recall@k/Precision@k/MRR/NDCG + 答案准确率/faithfulness
- Agent:任务成功率/轮数/工具调用准确率
- 自动驾驶:感知 mAP/mIoU;规划 NLE(nuScenes L2 error)、碰撞率、舒适度
数据处理与 Corner Case:
- 管线:采集(多传感器同步)→清洗→标注→预处理→入模/入库
- 清洗:亮度统计/拉普拉斯方差(模糊)/PSNR;pHash 去重;时间戳对齐;类别分布检查
- Corner Case 挖掘 5 法:①规则/标签筛选(夜/雨/逆光/施工)②无监督聚类找稀疏簇 ③模型不确定性采样(主动学习/难例挖掘:熵高、预测与真值偏差大)④VLM 语义辅助(生成场景描述→语义检索罕见组合)⑤生成式/仿真合成
- 为什么长尾重要:事故多在长尾;需数据平衡+主动挖掘+合成补充
- 数据增强:通用几何/光度 + 自动驾驶特有天气模拟、光照、对抗贴纸
3.5 技术自测题(口述一遍,卡壳回看上文)
- Self-Attention 计算流程?为什么除 √d_k?多头作用?2. 为什么需要位置编码?RoPE?3. KV Cache/Flash Attention 解决什么?4. BF16 vs FP16?5. RAG 完整流程?哪步最影响效果?6. 向量库怎么选?7. 混合检索+Rerank 是什么?8. RAG 怎么缓解幻觉、怎么评测?9. RAG vs 微调 vs 长上下文?10. ReAct vs Plan-and-Execute?11. Function Calling 流程?12. MCP 是什么?三个原语?13. 多 Agent 模式与坑?14. 端到端 vs 模块化?UniAD?15. VLM 通用架构?Projector?LLaVA 两阶段?16. VLM vs VLA?RT-2?17. 为什么自动驾驶用 VLM?18. LoRA 原理?为什么有效?19. QLoRA?20. 推理优化手段?21. Corner Case 挖掘 5 法?22. 数据清洗检查什么?23. 无人机项目安全投影层数学形式?24. 怎么从行车记录构建可检索场景库?
4. 算法手撕(完整代码,面试前默写一遍)
4.1 NMS
python
Copy
扩展:Soft-NMS(按 IoU 衰减分数);阈值常取 0.5/0.7;跨类别间不做 NMS
4.2 多头注意力(PyTorch)
python
Copy
4.3 二叉树层序遍历
python
Copy
4.4 反转链表
python
Copy
4.5 A*(讲思路)
open/closed 表;每次取 f = g + h 最小(g=已走代价,h=启发式曼哈顿/欧氏);h 可采纳(≤真实)则最优;h=0 退化为 Dijkstra。自动驾驶中 A* 用于全局路径,局部轨迹常用采样+优化/MPC。
4.6 小题速记
余弦相似度 cos=(a·b)/(|a||b|);softmax 数值稳定=先减 max;刷题优先级=LeetCode Hot100 前50(树/链表/二分/双指针)
5. HR 行为面试(定制版·参考电装/日企面经)
日企 HR 考察维度权重:稳定性 > 动机真实性 > 沟通人际 > 价值观
5.1 高频题定制答案
① 实习时间(必问!):我目前本科已毕业,正处于硕士入学前的衔接期,8 月就可以立刻到岗全职实习。9 月入学上海交通大学后,硕士课程我可以安排在晚上和周末集中修读,白天保证每周 4-5 天到岗,稳定实习 3 个月以上,如果项目需要,我可以长期实习,并承诺不中途无故离职。
② 为什么来电装/岗位:三个原因。第一,电装是丰田集团的核心供应商、全球头部汽车零部件企业,ADAS 和传感器领域积累深,上海技术中心是它在中国的重要研发基地。第二,这个岗位把大模型 Agent 用到自动驾驶研发流程里——研发 Agent、场景数据智能检索、VLM 与算法结合——正好覆盖我做过的东西(Agent 系统、RAG 检索、强化学习安全约束),是我判断未来几年最有价值的"大模型+汽车"交汇点。第三,我欣赏日企严谨的工程文化,想在这里学习规范的工程方法论。 (HR 追问"了解电装做什么吗"→ 背第 7 节业务板块)
③ 为什么日企/能接受日企文化:能接受。我在航空模型协会做过副会长,组织 50 多人次培训,习惯有纪律、重规范的协作。我理解日企重视流程、汇报和严谨性,这和我做事方式一致——我的项目都有完整文档和可复现实验。我也愿意学基础日语。
④ 加班看法:项目有 deadline 时加班没问题,我的项目都按节点交付过。但我更倾向用规划和自动化减少无效加班(比如 RAG 项目用 44 项自动化测试)。可以接受阶段性加班。
⑤ 英语:通过了英语四级,日常阅读英文论文和文档没问题(光伏论文是 IEEE 会议,全程英文写作投稿),听说还在加强。(直接背 1.3 英文自我介绍)
⑥ 日语:目前不会,但对日语有兴趣,如果需要愿意学基础日语用于日常沟通。
⑦ 职业规划:短期——硕士阶段把"大模型+自动驾驶"做深(Agent 工程、多模态数据、评测);中期——能独立负责"数据—模型—评测"闭环的算法工程师,有至少一个落地项目;长期——往端到端或 VLA 方向深耕。希望在电装实习完成从"会做 Agent"到"懂自动驾驶业务"的跨越。 (⚠️ 绝不说"实习就是积累经验以后去大厂")
⑧ 家里情况/籍贯(铜仁):我来自贵州铜仁,家庭很支持我在上海发展——我硕士就在上海交通大学读,未来也计划在长三角长期发展,稳定性可以放心。
⑨ 为什么来上海:硕士在上交、未来重心在上海;电装上海技术中心是电装中国重要研发基地,一举两得。
⑩ 其他 offer:主要在看上海的大模型和智能驾驶方向实习机会,电装是最优先选择,因为岗位方向和我的技术栈最匹配。(不主动报公司名;不说"好几个 offer 在挑")
⑪ 优缺点:优点——工程落地强(Agent/RAG 独立从零到 Docker 部署)、学习快(MCP/LangGraph 两周上手落地)。缺点——有时细节花时间过多(反复调 prompt),后来定规则:先跑通基线再优化,用评测数据说话。
⑫ 最大困难/失败:RAG 系统检索准确率卡在 60%,反复调 prompt/chunk 没用;意识到问题在检索侧而非生成侧,改混合检索+Rerank 后明显提升。教训:先定位问题在哪一层,别在最外层打补丁。
⑬ 团队合作/分歧:光伏论文分工(我负责数据与调优,共享实验记录保证结论一致,IEEE 录用);协会组织 50 多人次培训;无人机项目与同学对 PPO/SAC 有分歧→两边各跑一组实验用结果定方案。
⑭ 薪资期望:实习期主要看重项目经验和学习,薪资按公司标准来就好。
⑮ 希望从实习获得什么:三件事——完整参与真实自动驾驶场景的 Agent/数据检索项目、学习端到端和 VLM 落地方法、学日企规范工程流程。同时强调:我有 Agent/RAG 完整工程经验,可以很快上手产出,不是只来学习的。
⑯ 转正意向:如果实习表现得到认可、团队有 HC,非常希望能长期留下来,硕士还有三年,长期发展意愿明确。
⑰ 反问(HR 面挑 1-2 个):onboarding 流程和 mentor 制度?实习生第一个月先接触哪块工作?转正机制?(委婉)
5.2 避坑清单
❌实习时间含糊 ❌只说来学习(先给价值再提学习)❌贬低其他公司/前东家 ❌简历时间线对不上 ❌结束不道谢 ✅画像关键词:踏实、稳定、谦逊、能吃苦;回答前想 2 秒别抢话;结尾"谢谢您的时间,期待后续沟通!"
6. 英语面试
6.1 英文自我介绍 → 见 1.3(背熟,发音重于词汇)
6.2 高频英文 Q&A(背关键句)
- Why DENSO? → DENSO is a global top-tier automotive supplier and a core member of the Toyota Group, with strong investment in ADAS, electrification, and generative AI. This position combines large models with autonomous driving R&D — exactly the direction I want to grow in.
- Why this position? → It covers R&D agents, intelligent search over driving scene data, and VLM research. I have hands-on experience with RAG and agents, and I'm eager to apply them to real autonomous driving data.
- Strengths → engineering implementation (built a complete RAG system from scratch) and fast learning (LangGraph within two weeks).
- Weakness → sometimes spend too much time on details; I've learned to run a baseline first and optimize based on evaluation results.
- Career plan → deepen skills in large models for autonomous driving; eventually become an algorithm engineer owning the data-model-evaluation loop, then grow toward end-to-end driving or VLA.
- What is RAG? → embed documents into a vector database, retrieve relevant chunks for a question, feed them to the LLM with the question, so answers are grounded in real documents and hallucination is reduced.
- What is LoRA? → parameter-efficient fine-tuning: freeze the base model, train two small low-rank matrices; trainable parameters < 1%, saving GPU memory while keeping most performance.
- VLM vs VLA? → VLM takes images and text and outputs text (understanding); VLA additionally outputs actions (decision-making). RT-2 discretizes actions into text tokens.
- Any questions for us? → Yes, I'd like to know: what is the team's current direction, VLA or world model? / how is onboarding and mentorship for interns?
6.3 技术术语表
LLM大语言模型 / multimodal多模态 / end-to-end端到端 / RAG检索增强生成 / vector database向量数据库 / function calling工具调用 / agent智能体 / workflow orchestration工作流编排 / fine-tuning微调 / LoRA低秩适配 / quantization量化 / hallucination幻觉 / long-tail长尾 / corner cases边缘案例 / scene retrieval场景检索 / planning规划 / trajectory prediction轨迹预测 / occupancy grid占据栅格 / active learning主动学习 / hard example mining难例挖掘
6.4 应急句
"Sorry, could you repeat the question?" / "Let me think for a moment." / "I'm not very familiar with that, but my understanding is..." / "Thank you for your time."
7. 电装(DENSO)公司研究速查
⚠️ 具体数字面试前用官网/新闻核实后再引用
- 概况:1949 年从丰田分离,总部爱知县刈谷市,丰田集团核心供应商;全球第二大汽车零部件供应商(仅次于博世);集团员工约 16-17 万人;营收约 7 万亿日元量级
- 业务板块(背 3-4 个):①热系统(空调/散热,起家业务)②动力总成 ③电气化系统(逆变器/电机/电池管理)④移动出行电子(ECU、半导体、ADAS 毫米波雷达与摄像头、座舱)⑤新业务(机器人、氢能)
- ADAS/智驾:毫米波雷达/摄像头头部供应商;公开报道与地平线(征程芯片域控方案)、联发科(车规芯片/座舱)有合作 ※以最新官方消息为准;生成式 AI 用于研发提效是明确方向(本岗位即此落地)
- 中国:电装(中国)投资有限公司总部在上海;上海技术中心(闵行元电路 35 号)负责本地化研发——你的实习地
- 面试话术:"我了解到电装是丰田集团的核心供应商,在电动化和生成式 AI 上投入很大,上海技术中心是它在中国的重要研发基地,这个岗位把大模型用到自动驾驶研发流程里,是很有代表性的方向,所以很感兴趣。"
- 面试前 30 分钟:扫一眼 denso.com.cn 首页新闻 + 搜"电装 大模型/生成式AI/地平线"看 1-2 条最新消息
8. 反问环节 + 当天清单
8.1 反问(技术面挑 2 个 + HR 面挑 1 个)
- 这个岗位的研发 Agent 具体先解决自动驾驶研发中的哪个痛点?场景数据挖掘、仿真测试还是代码/文档辅助?
- 团队在端到端自动驾驶上更偏 VLA 路线还是 World Model 路线?VLM 更多用在数据侧还是决策侧?
- 团队现有驾驶场景数据规模什么量级?Corner Case 挖掘目前是规则驱动还是模型驱动?
- 大模型这块是自己部署开源模型还是用 API?实习生有 GPU 资源支持吗?
- 实习生 onboarding 流程?有 mentor 指导吗?(HR 友好)
- 实习表现好的话有转正/留用机会吗?(委婉)
- ❌ 别第一个问薪资/下班时间;问完让对话自然延续
8.2 面试前 24 小时清单
- 背熟中文自我介绍 2 分钟(念 3 遍掐表)
- 背熟英文自我介绍 2 分钟(念 3 遍)
- 默写 NMS + 多头注意力(不看答案)
- 口述:RAG 流程 / ReAct vs Plan / LoRA / 端到端 vs 模块化 / Corner Case 5 法
- 定制项目讲述 ①② 各讲 2 遍(含追问表)
- 过 HR 14 题 + 选好 3 个反问
- 看 1-2 条电装最新新闻
- 确认面试链接/会议号(别漏看 HR 消息!)、测试摄像头/麦克风/网络、装好会议软件
- 准备安静光线好的房间、纸笔、手机静音
- 早睡,设闹钟
8.3 面试当天
- 提前 10-15 分钟进会议候场;开场确认"能听到我说话吗?画面清楚吗?"
- 看摄像头(不是看屏幕);面试官说话点头回应不打断
- 答题先想 3 秒组织结构("我从三个方面回答");不会的诚实说+给推测+"回去补上"
- 结束时:"谢谢您的时间,期待后续沟通!"
9. 简历问题提醒(面试前务必处理)
- 邮箱拼写不一致:litianming@stu.cdut.edu.cn vs litanming@...(少了字母 i)→ 统一,否则 HR 联系不上
- 本科时间不一致:2023.07-2024.07(笔误)vs 2022.01 vs 2022.09 → 统一为 2022.09-2026.06
- 硕士时间不一致:2029.03 vs 2029.06 → 统一
- 手机号 19262840906 与邮箱 1524001843@qq.com / litianming@stu.cdut.edu.cn 多版本并存 → 面试当天保持手机畅通,确认 HR 有正确联系方式
祝面试顺利!你的定位:Agent 工程落地 + RAG 检索链路 + 强化学习安全约束 → 自动驾驶研发场景。缺的(VLM/端到端)诚实承认 + 给出学习路径,就是最好的回答。
上一篇:博格华纳 BorgWarner 机器人实习生 · 面试备考全案
下一篇:科驾技术 · AI底盘控制系统实习生 —— 完整面试复习笔记
评论与交流
评论管理 ↗